DevOps no es un cargo mágico, un producto ni un sinónimo de Docker o Kubernetes. Es una forma de reducir fricción entre quienes construyen, operan y mejoran software mediante cambios pequeños, automatización, retroalimentación y responsabilidad compartida por el resultado.
Esta URL recibió 11 impresiones en la ventana revisada, incluyendo búsquedas específicas de “devops en panama”. La señal todavía es modesta, pero la intención es independiente de una guía general de programación, así que conviene conservarla y convertirla en una ruta práctica en vez de dejar un texto superficial.
Qué problema intenta resolver DevOps
En un flujo frágil suelen aparecer síntomas como:
- “en mi máquina funciona”;
- despliegues manuales que dependen de una sola persona;
- pruebas que se ejecutan tarde;
- configuración que sólo existe en la memoria del equipo;
- cambios demasiado grandes para revisar con confianza;
- fallos que se descubren por clientes antes que por monitoreo;
- dificultad para revertir una versión;
- desarrollo y operaciones optimizando objetivos diferentes.
DevOps no elimina automáticamente esos problemas. Crea prácticas para hacerlos visibles, reducir su frecuencia y aprender de ellos.
1. Empieza por control de versiones
Antes de pensar en una plataforma CI/CD, el código, scripts y configuración relevante deberían tener una historia reproducible.
Con Git, practica:
- commits pequeños y explicables;
- ramas cuando el flujo las necesite;
- revisión de cambios;
- tags o versiones para releases;
- archivos de configuración documentados;
.gitignorepara impedir que secretos o artefactos locales entren al repositorio.
Nunca uses el repositorio como almacén de contraseñas, tokens o claves privadas.
2. Haz que una máquina pueda comprobar el cambio
La integración continua empieza por automatizar verificaciones cada vez que cambia el código.
Un pipeline básico puede ejecutar:
- instalar dependencias;
- lint o análisis estático;
- pruebas unitarias;
- build o empaquetado;
- una prueba mínima del artefacto generado.
GitHub Actions, por ejemplo, permite automatizar workflows de CI/CD dentro de un repositorio. La documentación oficial de GitHub Actions muestra cómo definir eventos, jobs y pasos.
La herramienta importa menos que la propiedad esencial: la comprobación debe poder repetirse sin depender de que alguien recuerde una lista manual.
3. Un build reproducible vale más que “funcionó una vez”
Si dos personas parten del mismo commit deberían poder obtener un resultado equivalente con instrucciones conocidas.
Eso exige controlar:
- versiones de dependencias;
- versión del runtime;
- variables de entorno requeridas;
- archivos o secretos externos;
- pasos de build;
- artefactos producidos.
Los contenedores pueden ayudar, pero no son obligatorios para aprender DevOps. Una aplicación pequeña con un script de build reproducible ya permite practicar el concepto.
4. Separa configuración de secretos
Una configuración como LOG_LEVEL=info no tiene el mismo riesgo que una clave API.
Documenta qué variables existen, pero gestiona secretos mediante mecanismos apropiados de la plataforma o entorno. Como mínimo:
- no los confirmes en Git;
- limita quién puede leerlos;
- usa credenciales diferentes por entorno cuando corresponda;
- rota una credencial que haya sido expuesta;
- concede sólo los permisos necesarios.
Una automatización con un token administrador permanente puede acelerar un deploy y al mismo tiempo crear un riesgo innecesario.
5. Automatiza el despliegue después de entenderlo
Antes de automatizar una secuencia, deberías poder explicar qué hace.
Un flujo inicial puede ser:
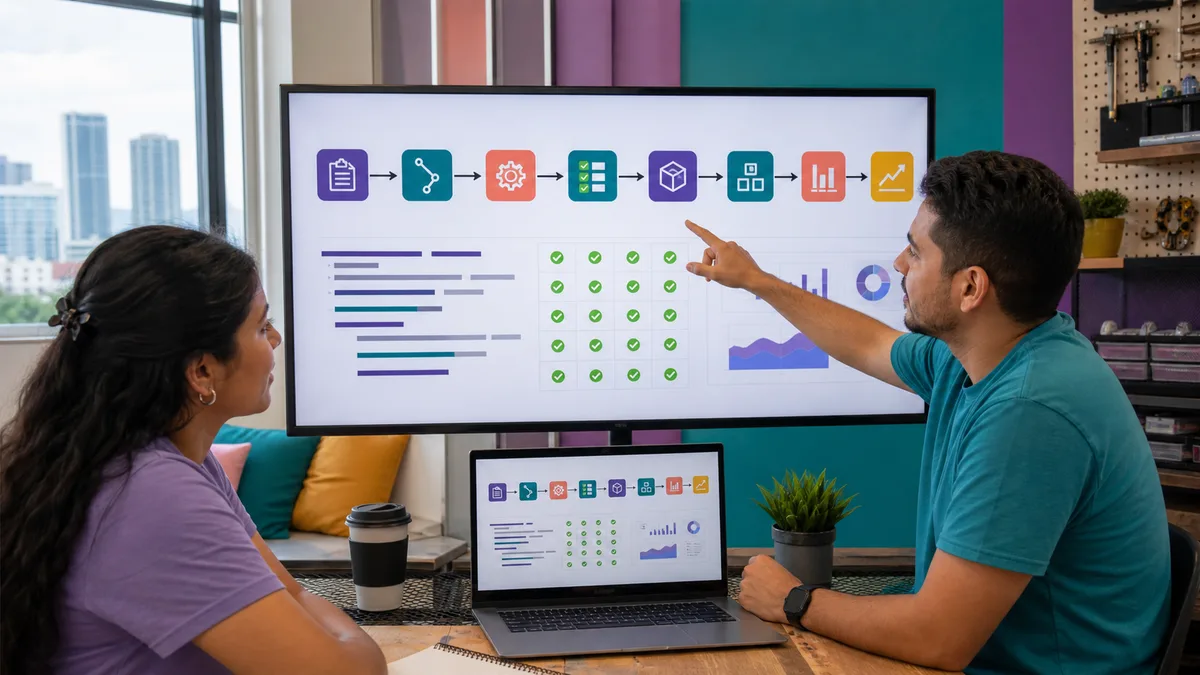
commit → pruebas → build → artefacto → staging → verificación → producción
Añade explícitamente:
- quién puede promover a producción;
- qué condición bloquea un release;
- cómo comprobar salud después del deploy;
- cómo volver a una versión conocida;
- qué se hace si una migración de datos no puede revertirse fácilmente.
Automatizar un procedimiento ambiguo sólo hace que el error ocurra más rápido.
6. Observabilidad: saber que el proceso terminó no significa saber que funciona
Un pipeline verde demuestra que sus verificaciones pasaron. No demuestra que los usuarios estén recibiendo un servicio sano.
Después de desplegar observa señales como:
- errores;
- latencia;
- disponibilidad;
- uso de recursos;
- colas o jobs retrasados;
- eventos de negocio relevantes;
- logs estructurados suficientes para investigar fallos.
El programa DORA mantiene un catálogo de capacidades de entrega de software que incluye prácticas técnicas y organizacionales como integración continua, entrega continua, observabilidad y mejora del proceso.
7. Rollback y recuperación forman parte del diseño
No esperes al incidente para descubrir cómo volver atrás.
Para una aplicación de práctica, documenta:
- cuál es la última versión conocida como estable;
- cómo volver a ella;
- qué ocurre con base de datos y archivos;
- qué señal confirma que la recuperación funcionó;
- qué información conservarás para analizar el fallo después.
A veces la estrategia correcta no es “rollback” literal sino corregir hacia adelante. Lo importante es que el equipo haya pensado el escenario antes de necesitarlo.
8. Cambios pequeños facilitan revisión y recuperación
Un release con cincuenta cambios no relacionados dificulta identificar qué produjo un fallo.
Cuando sea posible:
- reduce el tamaño de los cambios;
- integra con frecuencia;
- usa flags o mecanismos equivalentes cuando una función necesita separarse del despliegue;
- evita ramas que divergen durante largos períodos sin necesidad;
- automatiza pruebas relevantes cerca del cambio.
La meta no es desplegar muchas veces por prestigio. Es reducir el riesgo y obtener retroalimentación útil más rápido.
9. Qué medir
Las métricas deben ayudar a comprender el sistema, no a castigar personas.
Puedes observar:
- frecuencia de despliegues;
- tiempo desde un cambio hasta que llega al entorno objetivo;
- proporción de cambios que requieren corrección o generan incidente;
- tiempo de recuperación;
- duración de pipelines;
- pruebas inestables;
- trabajo manual repetido;
- incidentes recurrentes.
Una cifra aislada no define madurez. Interpreta tendencias junto con calidad, confiabilidad y objetivos del producto.
10. DevOps no obliga a empezar con Kubernetes
Para aprender, un stack más pequeño suele ser mejor.
Primero domina:
- Git;
- pruebas automatizadas;
- un pipeline CI;
- build reproducible;
- configuración y secretos;
- un deploy a staging;
- health check;
- logs;
- rollback o recuperación.
Después evalúa contenedores, orquestación, infraestructura como código o plataformas más complejas cuando resuelvan un problema real.
Un laboratorio práctico para empezar
Toma una aplicación sencilla y completa este recorrido:
- súbela a Git;
- añade al menos una prueba automatizada;
- crea un workflow que ejecute la prueba en cada cambio;
- genera un artefacto o build reproducible;
- despliega a un entorno de prueba;
- agrega una comprobación de salud;
- registra errores y eventos relevantes;
- fuerza un fallo controlado;
- recupera la versión estable;
- documenta qué parte todavía depende de pasos manuales.
Ese ejercicio enseña más que memorizar una lista de productos “DevOps”.
DevOps, SRE y Platform Engineering
Estos términos se solapan, pero no son idénticos.
- DevOps describe principios y prácticas para mejorar colaboración y flujo de entrega/operación.
- SRE aplica ingeniería de software a problemas de confiabilidad y operación, con prácticas y objetivos propios.
- Platform Engineering suele construir capacidades y plataformas internas para que otros equipos puedan entregar software con menos fricción.
Una organización puede utilizar ideas de los tres sin cambiar todos los cargos de su organigrama.
Formación y Crezendo
Crezendo mantiene áreas de formación en programación y habilidades técnicas, pero esta página no anuncia un curso permanente de DevOps, Kubernetes o una plataforma CI/CD concreta.
Puedes revisar los talleres vigentes o consultar un objetivo específico. Si la necesidad es empresarial, describe cómo construyen, prueban y despliegan hoy; esa información es más útil que pedir “un taller de DevOps” sin contexto.